🤖 Agents IA & Automatisation 📊 Data Science & ML ☁️ DevOps & Cloud 📈 Consulting Stratégique 🎓 Formation & Coaching 💼 Projets Blog À Propos Consultation gratuite

Saliou Diedhiou,
PhD en économétrie

Data Scientist et ingénieur IA, docteur en économétrie appliquée, diplômé du Master Data Science de Mines Paris – PSL et du Master DevOps / MLOps de Paris 1 Panthéon-Sorbonne. Fondateur de Nando IT Solutions à Toulon. Je conçois des modèles de machine learning et je développe des solutions IA complètes — agents LLM, systèmes RAG, applications FastAPI / React — jusqu'à la mise en production avec CI/CD et monitoring.

🎓 Doctorat · Bac+8 🏛️ Mines Paris – PSL 🏛️ Paris 1 Panthéon-Sorbonne ☁️ AWS SAA — en cours
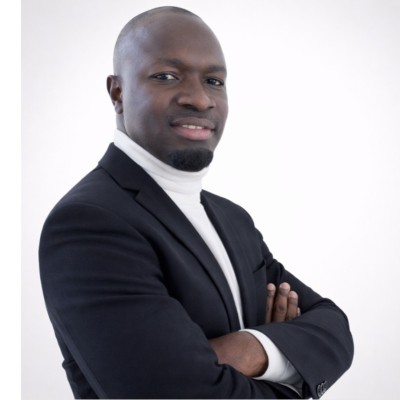
Saliou Diedhiou, Data Scientist et ingénieur IA à Toulon
📍 Toulon (83) — mobilité nationale, missions à distance
🗣️ Français courant · Anglais professionnel (publications)

De la recherche
à la production

J'ai passé cinq ans au Laboratoire d'Économie de Dijon à construire des modèles économétriques sur des données d'enquête à grande échelle. Ma thèse portait sur les déterminants de l'innovation environnementale : modèle de sélection de Heckman, régression censurée Tobit, bootstrap et tests de robustesse. J'y ai aussi enseigné les statistiques et la prévision aux universités de Bourgogne et de Perpignan.

Cette formation m'a donné un réflexe qui ne me quitte plus : vérifier les hypothèses d'un modèle avant d'en tirer des conclusions. Je l'ai ensuite portée côté ingénierie, avec le Master Data Science de Mines Paris puis le Master DevOps / MLOps de Paris 1 — 850 heures de formation pour apprendre à livrer, pas seulement à modéliser.

Chez Itinova, j'ai industrialisé des modèles de prévision et de détection d'anomalies sur les demandes d'hébergement d'urgence, pour la Métropole TPM et la Préfecture du Var. Puis j'ai fondé Nando IT Solutions pour développer mes propres produits SaaS et accompagner des clients sur des missions IA : RAG bancaire au Crédit Mutuel, analyse de données de santé à l'hôpital Sainte Musse, plateforme multi-agents myWASTE pour GreenOffice.

Ce que je fais aujourd'hui tient en une phrase : je choisis la méthode adaptée aux données disponibles, je mesure ce que je livre, et je le mets en production avec le monitoring qui va avec.

Discutons de votre projet Voir mes réalisations

📐 La méthode avant le modèle

Avant de lancer un XGBoost, je regarde les données : représentativité, valeurs manquantes, hypothèses du modèle. Un résultat non vérifié n'est pas un résultat.

📊 Mesurer plutôt qu'affirmer

Pour choisir un LLM chez GreenOffice, j'ai benchmarké 7 modèles sur 350 réponses avec une grille de notation pondérée qualité / hallucination / format. Le choix était chiffré, pas intuitif.

🚀 Jusqu'à la production

API FastAPI testée, Docker, pipelines GitLab CI/CD, monitoring Prometheus et dashboards Grafana. Le RAG du Crédit Mutuel tourne à 99,5 % de disponibilité avec traçabilité complète des requêtes.

🤖 Vibe coding, mais relu

Je développe au quotidien avec Claude Code : découpage en tâches, génération, puis relecture et tests du code produit. La vitesse ne dispense pas de la revue.

🗣️ Restituer à des non-techniciens

Élus, directeurs d'établissement, équipes médicales : j'ai l'habitude de traduire un modèle en note de synthèse et en tableau de bord Power BI, Shiny ou Streamlit.

Compétences & technologies

Quatre domaines qui se recoupent : la statistique pour choisir la bonne méthode, le machine learning pour modéliser, l'IA générative pour les interfaces, et le DevOps pour que tout cela tienne en production.

📈 Statistique & inférence

Estimation, tests d'hypothèses, puissance et taille d'échantillon, validation des hypothèses, bootstrap et robustesse.

Tests d'hypothèses Intervalles de confiance ANOVA Régression linéaire & logistique GLM Inférence causale (DiD, IV) Double ML Heckman & Tobit Données de panel Bootstrap ACP Économétrie

🧠 Data Science & Machine Learning

Modèles supervisés et non supervisés, séries temporelles, détection d'anomalies et deep learning.

XGBoost Random Forest Lasso / Ridge Clustering Isolation Forest Autoencodeurs Prophet ARIMA / VAR LSTM PyTorch TensorFlow Keras scikit-learn PySpark

🤖 IA générative & agents

Agents LLM orchestrés, systèmes RAG traçables, vision par ordinateur et contrôle strict des sorties.

LangChain LangGraph Systèmes multi-agents RAG hybride ColPali Qdrant ChromaDB Claude API Mistral Gemini AWS Bedrock Prompt engineering Sorties JSON validées SAM 3 RF-DETR Claude Vision Claude Code

☁️ DevOps, MLOps & Cloud

Infrastructure as code, CI/CD industriel, orchestration Kubernetes, monitoring et sécurité.

AWS (EKS, EC2, S3, IAM, VPC, Lambda) Terraform Ansible / AAP Kubernetes Helm Docker GitLab CI/CD Jenkins GitHub Actions MLflow Prometheus Grafana AlertManager ELK Stack SonarQube Trivy / OWASP ZAP Velero Railway

💻 Développement

Python R Stata SQL Bash YAML FastAPI React Vite Next.js Tailwind Boto3 Pydantic LaTeX

🗄️ Données & stockage

PostgreSQL MySQL MongoDB Supabase Qdrant ChromaDB Elasticsearch S3 pandas NumPy SciPy statsmodels

📊 Restitution & métier

Power BI Streamlit Shiny Grafana Notes de synthèse RGPD Scrum ITIL / ITSM Enseignement Stripe

Expérience & formation

Huit ans entre recherche académique, data science en collectivité et missions d'ingénierie IA en freelance.

🏢 Expérience professionnelle

♻️
JUIN 2026 — AOÛT 2026

Data Scientist & Ingénieur IA

GreenOffice / Storkcom — La Rochelle (à distance) · Freelance

myWASTE, plateforme de mesure et de réduction du gaspillage alimentaire en restauration scolaire.

  • Plateforme multi-agents en Python : 10 agents spécialisés orchestrés (déchets, satisfaction, bilan carbone, menus, chatbot), analyse d'images de bacs via Claude Vision.
  • Backend RAG FastAPI + ChromaDB : 5 prompts système, validation stricte du JSON, gestion d'erreurs et 9 règles anti-hallucination.
  • Benchmark automatisé de 7 LLM (Claude, Mistral, Gemini) : 350 réponses notées, scoring pondéré qualité / hallucination, rapports Excel et arbitrage coût / performance.
  • Vision par ordinateur : architecture SAM 3 + RF-DETR fusionnée aux capteurs de pesée, pipeline MLOps de ré-entraînement continu à partir des corrections utilisateurs.
  • Résultat : architecture livrée, documentée et mise en production par le client.
PythonFastAPIChromaDBClaude VisionSAM 3RF-DETRPydantic
🏦
FÉV 2026 — AVR 2026

Data Scientist / Ingénieur IA — RAG multimodal

Crédit Mutuel — Toulon Liberté · Freelance

Mise en production d'un système de questions-réponses sur une documentation technique bancaire volumineuse, soumis aux exigences de fiabilité et de conformité du SI.

  • Pipeline d'ingestion de milliers de documents, embeddings sémantiques ColPali et indexation vectorielle Qdrant.
  • Retriever hybride dense + sparse, service de génération exposé en API FastAPI, code testé et versionné.
  • Indicateurs de qualité des réponses, monitoring Prometheus, dashboards Grafana, logs structurés et traçabilité complète des requêtes pour l'audit.
  • Résultats : 60 % de réduction des erreurs IA, 99,5 % de disponibilité en production.
RAGQdrantColPaliFastAPIPrometheusGrafanaDocker
🏥
AOÛT 2025 — OCT 2025

Data Scientist / Ingénieur IA — Données de santé

Hôpital Sainte Musse — Toulon · Freelance

Analyse de données patients en milieu hospitalier pour appuyer le diagnostic et la planification des traitements, dans un cadre RGPD strict.

  • Pipeline LangChain intégrant des sources hétérogènes : dossiers patients (EHR), laboratoires, imagerie.
  • Structuration et contrôle qualité des données multi-sources ; analyse de patterns et de corrélations pour la détection précoce de pathologies.
  • Recommandations générées par LLM, conformité RGPD et restitution des analyses aux équipes médicales.
LangChainLLMNLPDonnées de santéRGPD
☁️
AVR 2025 — DÉC 2025

Architecte Cloud & Lead Infrastructure DevOps

Projet Sock Shop — E-commerce microservices en production (projet fil rouge, équipe)

Conception et exploitation d'une infrastructure AWS multi-tiers 100 % Infrastructure as Code pour une plateforme e-commerce en microservices.

  • AWS EKS 1.30, VPC privé, NAT Gateway unique ; Terraform en deux couches : 15 min d'infrastructure, 2 min de configuration logicielle.
  • Pipeline GitLab CI/CD en 5 étapes (Validate → Infrastructure → Configuration → Deploy → Destroy) avec scan de sécurité Trivy intégré.
  • Kubernetes en production : Nginx Ingress, NetworkPolicies, TLS ACM, MySQL + MongoDB.
  • Stack Prometheus / Grafana + AlertManager Slack, plan de reprise Velero, FinOps : −70 % de coûts via scripts de nettoyage ELB/EBS et capacity planning.
AWS EKSTerraformKubernetesGitLab CI/CDPrometheusTrivyVelero
🚀
JANV 2024 — AOÛT 2026

Fondateur, Data Scientist & Développeur IA

Nando IT Solutions — Toulon

Conception et développement de produits SaaS intégrant de l'IA générative, du prototype au déploiement en production.

  • Vigila HSE : SaaS QHSE avec agents IA, FastAPI + React / Vite / Tailwind, architecture multi-tenant, authentification JWT, RAG contraint « zéro hallucination », paiements Stripe.
  • ComptaFlow : SaaS de comptabilité React / Vite / Supabase, abonnements Stripe, CI/CD GitHub Actions.
  • AgriSmart et agence immobilière IA : applications FastAPI + React multi-agents, tableaux de bord connectés à des API (Open-Meteo).
  • Plateforme marketing multi-agents (Next.js) : agents connectés à Gmail et Google Drive, automatisation de publications LinkedIn.
  • Déploiement : Railway, Hostinger, Docker, GitHub Actions. Développement accéléré par vibe coding avec Claude Code, avec relecture et tests du code généré.
FastAPIReactNext.jsSupabaseStripeClaude APIClaude Code
📊
OCT 2022 — JANV 2026

Data Scientist & Ingénieur Automatisation

Itinova — Toulon · CDI · Clients : Métropole TPM, Préfecture du Var

Traitement de données massives sur les demandes d'hébergement d'urgence et d'insertion : automatiser l'analyse, anticiper la demande et outiller la décision publique.

  • Statistiques descriptives et inférentielles : tests d'hypothèses, régressions multiples, ANOVA, validation des hypothèses des modèles.
  • Modèles prédictifs supervisés (XGBoost, Random Forest) et séries temporelles (Prophet, ARIMA, LSTM) pour anticiper les demandes à fort volume du 115.
  • Détection d'anomalies comportementales (Isolation Forest, autoencodeurs, LSTM) packagée en services Python testés et documentés.
  • Analyse multivariée : réduction de dimension (ACP), classification, sélection de variables ; feature engineering et ETL Python / R.
  • Industrialisation : API FastAPI, Docker, pipelines GitLab CI/CD ; restitution aux élus et directeurs via dashboards Streamlit, Shiny et Power BI.
PythonRXGBoostProphetLSTMPostgreSQLGitLab CI/CDPower BI
🔬
SEP 2017 — DÉC 2022

Chercheur doctorant en économétrie appliquée

Université de Bourgogne — Laboratoire d'Économie de Dijon (LEDi)

Thèse : modélisation prédictive et causale des déterminants de l'innovation environnementale, à partir des enquêtes Community Innovation Survey (CIS) et de données Insee.

  • Modèle structurel en 3 étapes (Crépon-Duguet-Mairesse) : modèle de sélection de Heckman, régression censurée Tobit, fonction de production de connaissances.
  • Validation statistique : bootstrap, tests de robustesse, vérification des hypothèses d'identification.
  • Machine learning : Random Forest et XGBoost (validation croisée stratifiée, réglage des hyperparamètres), Lasso / Ridge en grande dimension.
  • Préparation de données d'enquête à grande échelle : valeurs manquantes, valeurs aberrantes, harmonisation des variables.
  • Publications internationales en anglais ; enseignement des statistiques, de l'économétrie et de la prévision (TD et cours, universités de Bourgogne et de Perpignan).
RStataÉconométrieInférence causaleHeckman / TobitBootstrapEnseignement

🎓 Formation académique

☁️
2024 — 2025 · 450 H

Master Ingénierie DevOps, MLOps & Cloud

Université Paris 1 Panthéon-Sorbonne

Infrastructure as Code, conteneurisation et orchestration Kubernetes, CI/CD industriel, monitoring et sécurité des plateformes cloud.

🧠
2022 — 2023 · 400 H+

Master Data Science

Mines ParisTech – PSL

Machine learning supervisé et non supervisé, deep learning, séries temporelles, big data et industrialisation des modèles.

🎓
2017 — 2022 · BAC+8

Doctorat en Économétrie appliquée

Université de Bourgogne · Dijon

Modélisation prédictive et causale des déterminants de l'innovation environnementale. Publications internationales et enseignement universitaire des statistiques et de la prévision.

🏆 Certifications cloud

☁️
AWS Solutions Architect – Associate
Amazon Web Services
En cours
🐳
Certified Kubernetes Administrator (CKA)
CNCF
Objectif 2026
🎩
Red Hat Certified Specialist in Ansible
Red Hat
Cible

📜 29 certifications DataScientest

Obtenues entre février 2023 et septembre 2025, sur les deux parcours Data Science / Deep Learning et DevOps / MLOps.

DevOps & MLOps · 2024 — 2025

Terraform · 09/2025 Ansible · 09/2025 GitLab · 06/2025 Unit Testing · 06/2025 Jenkins · 05/2025 Kubernetes · 05/2025 Docker · 04/2025 Elasticsearch · 04/2025 MongoDB · 03/2025 Bases relationnelles · 03/2025 Data en entreprise · 01/2025 FastAPI · 11/2024 Intégration de données API · 11/2024 Python for DevOps · 11/2024 Bash & Linux · 11/2024

Data Science & Deep Learning · 2023

RNN TensorFlow · 08/2023 TensorFlow · 07/2023 RNN PyTorch · 07/2023 CNN PyTorch · 06/2023 CNN Keras · 06/2023 Dense NN Keras · 06/2023 SQL for Data Science · 05/2023 ML with PySpark · 05/2023 Séries temporelles · 03/2023 Réduction de dimension · 03/2023 Régression scikit-learn · 03/2023 Clustering scikit-learn · 03/2023 Classification avancée · 02/2023

Mes CV au format PDF

Cinq versions selon l'angle du poste. Même parcours, mise en avant différente.

Collaborons
ensemble

Mission freelance, CDI ou consulting : parlons de ce que vous cherchez à construire. Premier échange de 30 minutes sans engagement.